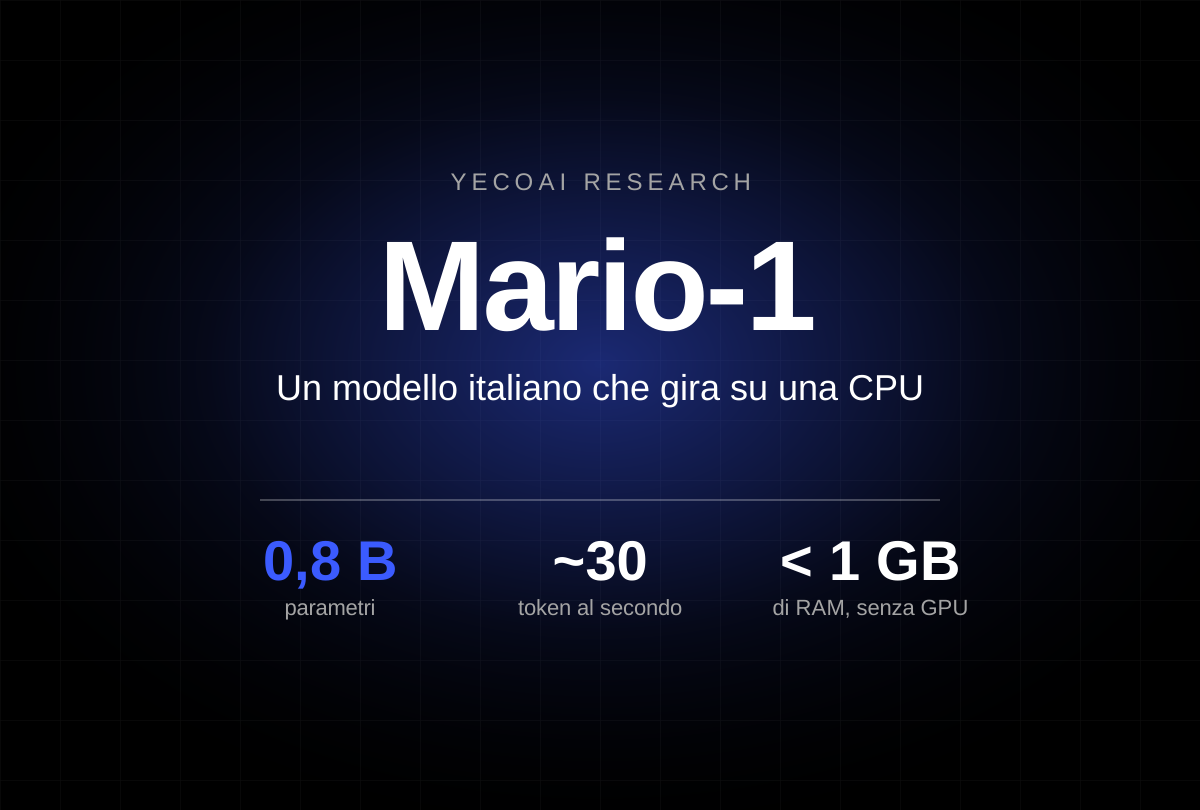
Mario-1: un modello italiano che gira su una CPU
Un modello linguistico da 0,8 miliardi di parametri, addestrato per l'italiano. Gira su CPU senza GPU e sa riconoscere le trappole, ammettere ciò che non sa e fare calcoli affidabili.
Research

La prima versione del nostro modello per trovare i dati personali. Ha superato modelli concorrenti più grandi in sei lingue europee.
Presentiamo Yeco-PII v1.0, un modello neurale da 278M di parametri per la detection e l’anonimizzazione di PII che supera sia Rizzo-PII (0,3B) sia l’OpenAI Privacy Filter (1,5B), un modello 5,4× la sua dimensione, su tutte e sei le lingue europee testate: F1 medio 0,966 contro 0,726 e 0,776 sul protocollo storico della v1.0 (gold a 17 tag), con punteggi per lingua da 0,92 (olandese) a 0,99 (francese). Il modello rileva 24 tipi di entità, inclusi nomi, codici fiscali e indirizzi privi di checksum da validare, leggendo il contesto anziché applicando formule, con copertura italiana nativa (codice fiscale, partita IVA, dati catastali) e un motore di policy di anonimizzazione che trasforma la detection in redazione pronta per la produzione. Questo articolo documenta motivazione, metodologia di benchmark, analisi degli errori e storia del deployment.
Il tooling classico per la PII si affida alla validazione di formato: un IBAN sopravvive al mod-97, una carta di credito al Luhn. Funziona per le entità che la matematica può controllare e fallisce per le entità che dominano i documenti reali. Nomi, indirizzi, organizzazioni e date non hanno checksum; un validatore o accoppia un dizionario finito (perdendo tutto ciò che è nuovo) o accetta una forma regex (accettando spazzatura). Sulle righe del benchmark Ai4Privacy il divario si concentra esattamente lì: i modelli legacy e general-purpose perdono 20-30 punti F1 su nomi di persone e indirizzi, restando adeguati sulle poche entità verificabili via formula.
Il secondo fallimento è semantico. Una data non è una data: una data di nascita va censurata; la data di entrata in vigore di un regolamento va mantenuta. Un nome non è un nome: l'ente certificatore in un attestato è un'organizzazione, non una persona. Strumenti privi di contesto non possono fare queste distinzioni, quindi sovra-censurano (distruggendo l'utilità del documento) o sotto-censurano (esponendo proprio i dati che l'esercizio esiste per proteggere). La tesi di Yeco-PII è che questo è un problema di comprensione del linguaggio, e va risolto con un modello linguistico dimensionato per il compito, non con un generalista più grande.
Yeco-PII v1.0 è un encoder da 278M di parametri addestrato per il riconoscimento di entità a livello di token su 24 tipi protetti: nomi di persone, organizzazioni, codici fiscali, partite IVA, IBAN, carte di credito, email, numeri di telefono, date di nascita, indirizzi, CAP, province, importi, riferimenti documento, targhe e altro, con tag affiancati che distinguono occorrenze semanticamente diverse (data di nascita vs data di riferimento). Il modello è distribuito in formato HuggingFace standard (~1,1 GB), gira a ~3.700 caratteri/secondo su CPU (~1 GB di RAM a regime) e si integra come semplice passo di pipeline. Le politiche di censura, masking, pseudonimizzazione o sostituzione che preserva il formato, si definiscono in JSON o linguaggio naturale e si applicano all'istante, senza riaddestramento.
La valutazione usa un misto di dati reali e sintetici ispirati a scenari reali, mai visti in training, annotati da terzi (Ai4Privacy), con lo stesso set di test per ogni modello confrontato. Protocollo storico della v1.0: gold a 17 tag (senza IP, USERNAME, TIME e COUNTRY), misurato a settembre su documenti Ai4Privacy held-out, composti da dati reali e sintetici ispirati a scenari reali. Il risultato di testa: F1 medio 0,966 per Yeco-PII v1.0 (multilingua, 6 lingue), contro 0,776 dell’OpenAI Privacy Filter (1,5B, valutazione type-agnostic) e 0,726 di Rizzo-PII (0,3B, valutazione tollerante), con vittorie su tutte e sei le lingue: italiano, inglese, francese, tedesco, spagnolo, olandese. Su 600 righe italiane, stesso protocollo, l’F1 è ~0,966, con codice fiscale, partita IVA, IBAN, email, telefoni, nomi e indirizzi tra 0,94 e 0,99.

| Lingua | Yeco-PII v1.0 (278M) | Rizzo-PII (0.3B) | OpenAI Privacy Filter (1.5B) |
|---|---|---|---|
| Media 6 lingue | 0.97 | 0.73 | 0.78 |
Con il protocollo attuale (gold esteso a 30 tag, inclusi IP, USERNAME, TIME, COUNTRY e GEOCOORD), misurato il 17 ottobre 2026 su 600 righe italiane, Yeco-PII v1.0 ottiene P 0,970, R 0,734, F1 0,835, contro P 0,984, R 0,969, F1 0,977 di Yeco-PII 2.0. Il calo da 0,966 a 0,835 non è una regressione: il gold ora include categorie che la v1.0 non è mai stata addestrata a rilevare (TIME, IP e USERNAME a F1 0,000, circa 830 entità mancanti su 600 righe). Sulla suite avversariale, la v1.0 ottiene F1 0,912 (P 0,984, R 0,849), contro 0,950 della 2.0.
Il resoconto onesto include i mancati. Gli errori residui si concentrano su tre aree: entità fortemente abbreviate o malformate (un cognome spezzato da artefatti di formattazione), nomi stranieri rari fuori dai pattern europei e casi limite in cui il layout del documento (tabelle, firme) disperde un'unica entità logica. Ciascuno è più un problema di dati che di architettura, ed è tracciato nell'harness di valutazione; la model card per i clienti con licenza include il dettaglio per categoria.
La detection da sola non basta. Il motore di policy trasforma gli span in azioni: mascheramento con tag di tipo, sostituzione con surrogati realistici che preservano il formato (un codice fiscale anonimizzato resta di 16 caratteri e supera i controlli di formato) o sostituzione con mappature per cliente che restano coerenti su tutti i documenti di un corpus. Le policy in linguaggio naturale compilano nella stessa rappresentazione interna di quelle JSON, il team compliance scrive "mantieni totali fattura e partite IVA, censura tutto ciò che riguarda il cliente", e il motore lo implementa in modo verificabile. Il modello è usato nel prodotto DeskNexo per anonimizzare i ticket prima che arrivino ai modelli di terze parti.
L'accesso enterprise parte con un trial API sui documenti del cliente; la licenza è a pagamento una tantum con consegna on-premises in formato HuggingFace, il modello gira interamente nel perimetro del cliente, senza costi a richiesta e senza egress dei dati. Le API pubbliche per sviluppatori individuali e team più piccoli arrivano in modo progressivo. Dentro YecoAI, Yeco-PII è il layer di privacy di DeskNexo: i dati dei ticket sono anonimizzati prima che qualunque modello di terze parti li elabori.
Yeco-PII v1.0 mostra che il problema della PII premia la comprensione più della scala: un modello da 278M che legge il contesto batte un generalista da 1,5B su ogni lingua testata, gira su CPU e costa una frazione a regime. Per le organizzazioni con un obbligo di compliance, hosting, sanità, banking, il risultato è pratico: anonimizzazione di livello GDPR che sta in una VM, licenziata una volta, in esecuzione dove i dati già vivono. L'harness di benchmark, la model card e la documentazione d'integrazione sono disponibili per i partner di valutazione su richiesta.
Il contesto batte i checksum: F1 medio 0,966 su sei lingue (protocollo storico v1.0) con 278M di parametri, italiano nativo. La privacy è un problema di linguaggio, e i problemi di linguaggio hanno risposte piccole e oneste.
Un modello linguistico da 0,8 miliardi di parametri, addestrato per l'italiano. Gira su CPU senza GPU e sa riconoscere le trappole, ammettere ciò che non sa e fare calcoli affidabili.
Il nostro nuovo modello che trova e nasconde i dati personali nei testi. Più preciso della versione precedente e migliore di modelli molto più grandi, soprattutto in italiano. Ogni release è firmata digitalmente, così puoi verificarne l'autenticità.
Micro-LLM italiano da 118M parametri, addestrato con meno di €15, ~200 tok/s su CPU. Batte Minerva-350M (3× più grande) su BoolQ-IT.