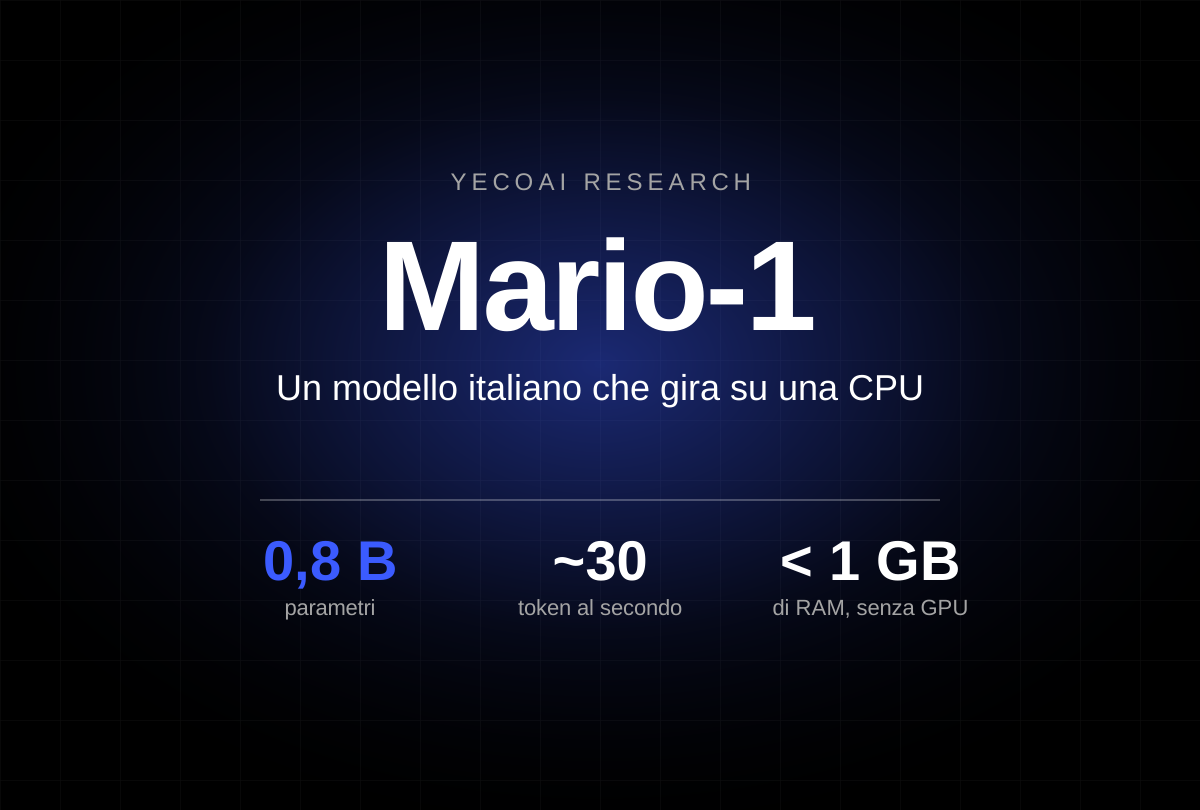
Mario-1: un modello italiano che gira su una CPU
Un modello linguistico da 0,8 miliardi di parametri, addestrato per l'italiano. Gira su CPU senza GPU e sa riconoscere le trappole, ammettere ciò che non sa e fare calcoli affidabili.
Research

Il nostro modello AI per EnderDevelopment, un fine-tuning di Qwen2.5-Coder-1.5B (Apache 2.0). Usato solo dentro il prodotto e non disponibile pubblicamente.
Nota di correzione: in una prima versione di questa pagina Ender-1 era indicato come fine-tuning di Qwen2.5-Coder-3B. Dopo i chiarimenti sulla licenza, il 3B risulta distribuito con licenza non commerciale: Ender-1 è quindi basato sul 1.5B (Apache 2.0). Dettagli nella correzione completa.
Ender-1 è il modello di codice proprietario dietro EnderDevelopment: un fine-tuning fortemente ottimizzato di Qwen2.5-Coder-1.5B, addestrato sui dati d'uso di EnderDevelopment stessa. Non è un modello general purpose e non fa parte della Yeco LLM Series, che resta interamente proprietaria: Ender-1 eredita la base Apache 2.0 di Qwen e la specializza per un solo compito, trasformare le intenzioni della community gaming in plugin Minecraft funzionanti, script FiveM, bot Discord e configurazioni server valide. Non verrà mai rilasciato come open weight né tramite API pubblica: Ender-1 vive esclusivamente dentro EnderDevelopment, e questo articolo documenta cosa è, come è stato costruito e il suo piano di rollout.
Ender-1 parte da Qwen2.5-Coder-1.5B, un piccolo modello di codice con licenza Apache 2.0, e lo adatta con una ricetta in due fasi: pretraining continuo sulla distribuzione codice-e-config di EnderDevelopment (plugin Spigot/Paper in Java/Kotlin, plugin.yml, alberi di permessi, YAML/JSON di BungeeCord/Velocity, Lua FiveM, sorgenti di bot Discord), seguito da instruction tuning su coppie intento-to-artefatto dal traffico reale della piattaforma. Il risultato è deliberatamente stretto: dove il modello base è un assistente di codice generale, Ender-1 è uno specialista degli stack esatti e delle forme di richiesta che EnderDevelopment serve.
La distinzione conta. I modelli della Yeco LLM Series (Yeco-PII, Flash Mini-IT) sono addestrati da zero o sulle nostre pipeline e sono interamente proprietari. Ender-1 è un'altra categoria: un fine-tuning di un'ottima base aperta, ottimizzato e valutato così da battere generalisti più grandi sul suo terreno di casa. Dati verticali e valutazione rigorosa battono la scala pura in un dominio ristretto, lo stesso principio per cui Yeco-PII supera modelli 5,4× più grandi sulla detection di PII.
Il corpus di fine-tuning proviene esclusivamente dal tier free di EnderDevelopment, secondo la policy consolidata della piattaforma: prompt e generazioni accettate de-identificati, nessun identificativo account o dato di pagamento, asset copyrighted di terzi filtrati, opt-out a livello di account rispettato in ogni snapshot di training. I prompt già elaborati dalla piattaforma sono il seme; il loop che si compone (più utenti, più intenzioni, modello migliore, generazioni migliori) è il vero asset.
Ender-1 non verrà rilasciato come open weight, non sarà servito tramite API pubblica e non sarà in licenza: gira solo dentro EnderDevelopment. I motivi sono pratici, non ideologici. Il valore del modello è inseparabile dalla pipeline di verifica della piattaforma (controlli di compilazione, validazione delle config, test funzionali), quindi servirlo da solo eliminerebbe esattamente ciò che rende affidabili i suoi output. Rilasciarlo consegnerebbe inoltre ai concorrenti la distillazione del nostro dataset più prezioso. EnderDevelopment ha sempre usato modelli europei per la sua pipeline, Codestral Latest fra questi, ed Ender-1 è il passo in cui il modello proprietario della piattaforma subentra in quel ruolo.
Ender-1 arriva agli utenti di EnderDevelopment a fasi, con la pipeline precedente mantenuta come fallback a ogni passo e come verificatore permanente di ciò che Ender-1 produce. Ender-1 è disponibile solo dentro EnderDevelopment. La struttura:
Ogni output di Ender-1 viene compilato, pacchettizzato e verificato funzionalmente prima di arrivare a un utente, la stessa disciplina dual-LLM che protegge DeskNexo: Ender-1 propone, la pipeline di produzione verifica. Le regressioni emergono in poche ore perché l'insieme di valutazione è il traffico stesso della piattaforma.
L'agenda segue il rollout: pubblicare metriche di qualità aggregate per ogni fase (successo di generazione, tassi di superamento funzionale per categoria), iterare checkpoint a cadenza fissa mentre il corpus cresce, e decidere con calma se Ender-1 sostituirà del tutto la pipeline precedente. Ender-1 è il primo modello YecoAI nato da un prodotto vivo, e il template di come funziona il nostro motore di dati: uso reale, governato da policy, qualità che si compone.
Distribuzione prima, dati da intenzioni reali, valutazione per compilazione. Ender-1 è come appare un fine-tuning product-trained quando il loop si chiude.
Un modello linguistico da 0,8 miliardi di parametri, addestrato per l'italiano. Gira su CPU senza GPU e sa riconoscere le trappole, ammettere ciò che non sa e fare calcoli affidabili.
Il nostro nuovo modello che trova e nasconde i dati personali nei testi. Più preciso della versione precedente e migliore di modelli molto più grandi, soprattutto in italiano. Ogni release è firmata digitalmente, così puoi verificarne l'autenticità.
Micro-LLM italiano da 118M parametri, addestrato con meno di €15, ~200 tok/s su CPU. Batte Minerva-350M (3× più grande) su BoolQ-IT.