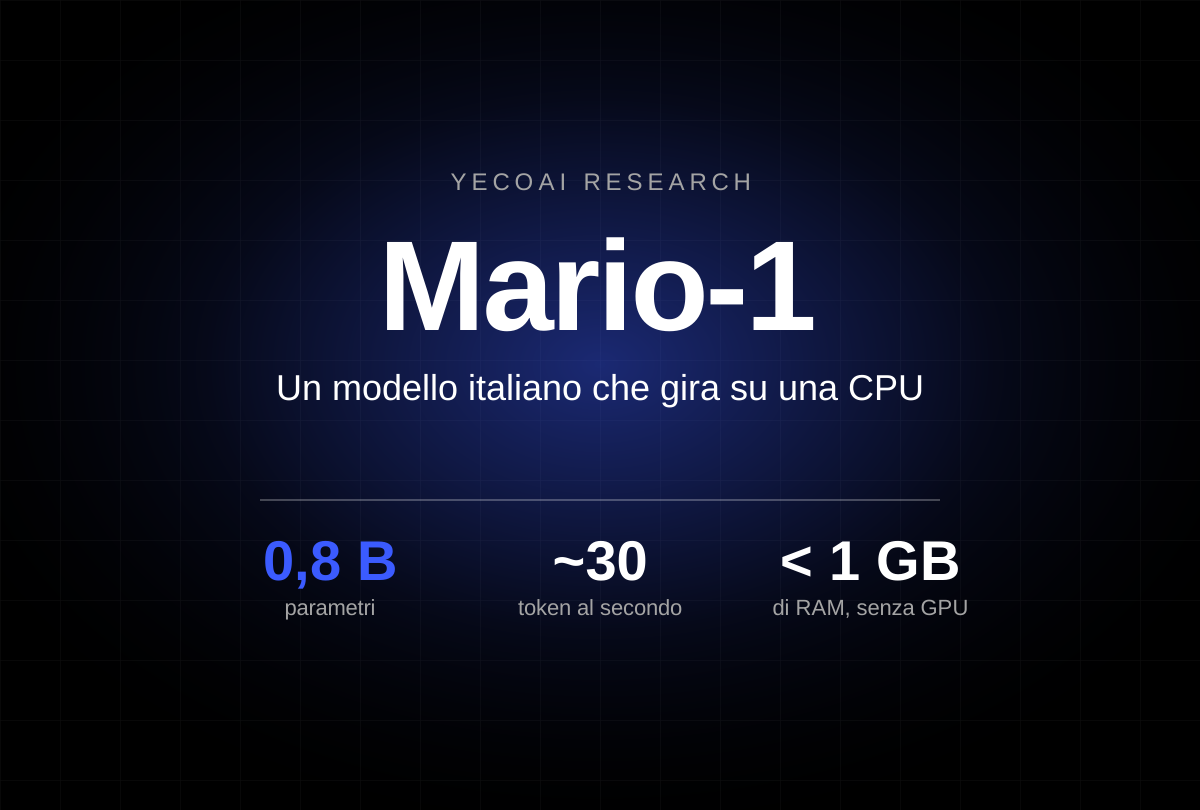
Mario-1: un modello italiano che gira su una CPU
Un modello linguistico da 0,8 miliardi di parametri, addestrato per l'italiano. Gira su CPU senza GPU e sa riconoscere le trappole, ammettere ciò che non sa e fare calcoli affidabili.
Research

Modelli AI sperimentali che parlano napoletano e piemontese, rilasciati come esperimenti aperti. Sono versioni iniziali e non fanno parte della nostra linea di prodotti principale.
L'italiano standard è quello dei libri di testo; l'Italia parla in varietà regionali, dal napoletano al piemontese e a decine di altre, che non sono accenti ma sistemi linguistici con lessico, morfologia e sintassi propri. Per la tecnologia linguistica questa diversità è un punto cieco: un modello valutato solo sull'italiano standard fallisce silenziosamente con i milioni di parlanti che scrivono come parlano. Come primi esperimenti in questa direzione abbiamo realizzato due modelli conversazionali aperti per i dialetti, Napoletano-Ciro e Piemontese-Gioan. Sono artefatti di ricerca, non prodotti: release sperimentali che potranno ricevere aggiornamenti migliori in futuro.
I cosiddetti dialetti italiani sono, in termini linguistici, lingue romanze evolutesi in parallelo all'italiano toscano. Napoletano e piemontese hanno profonde tradizioni letterarie, e l'intelligibilità reciproca con l'italiano standard è parziale nel migliore dei casi. Trattare queste varietà come rumore attorno a uno standard, refusi, slang, accento, significa buttare via struttura che un modello potrebbe apprendere: sostituzioni lessicali sistematiche, differenze morfologiche regolari e pattern sintattici stabili.
Napoletano-Ciro e Piemontese-Gioan sono adapter LoRA (PEFT, Parameter-Efficient Fine-Tuning) applicati a Qwen/Qwen2.5-1.5B-Instruct, un modello base open-weights di terze parti. Il modello base non è stato addestrato da noi: il nostro contributo è l'adattamento. Ogni adapter è stato addestrato con Supervised Fine-Tuning su coppie conversazionali dialettali curate, con ottimizzatore AdamW e schedule lineare. Entrambi sono pubblicati su Hugging Face con licenza Apache 2.0, e una demo pubblica, la Space ciro-gioan-chat, permette di parlare con i due personaggi fianco a fianco.
Il dialetto vive nella conversazione quotidiana, quindi abbiamo scelto un formato conversazionale anziché orientato ai benchmark: personaggi fissi danno ai modelli una voce coerente e rendono la qualità giudicabile parlandoci. La base da 1,5B mantiene gli adapter economici da addestrare, eseguibili su CPU e condivisibili apertamente, cosa importante per varietà a basse risorse dove l'obiettivo è copertura e sperimentazione con la community, non le classifiche.
Sono esperimenti iniziali. Abbiamo in programma di iterare: corpora meglio curati, più varietà e una valutazione più solida sono i passi successivi naturali, e le versioni future degli adapter potranno migliorare in modo sostanziale.
Napoletano-Ciro e Piemontese-Gioan non fanno parte della Yeco LLM Series. La serie è la nostra famiglia di modelli proprietari interni (Yeco-PII v1.0, Ender-1 e Yeco Flash Mini-IT v1), addestrati sulle nostre pipeline. Gli adapter dialettali sono una linea di ricerca separata: esperimenti autonomi costruiti su una base open-weights di terze parti, rilasciati con licenza Apache 2.0 perché chiunque possa ispezionarli, eseguirli o estenderli.
Con Napoletano-Ciro e Piemontese-Gioan abbiamo fatto un primo passo onesto nell'NLP dei dialetti italiani: esperimenti conversazionali piccoli e aperti che mettono due lingue regionali in una finestra di chat. Provateli, stressateli, diteci dove falliscono: quel feedback è esattamente ciò che serve alla prossima iterazione.
Un modello linguistico da 0,8 miliardi di parametri, addestrato per l'italiano. Gira su CPU senza GPU e sa riconoscere le trappole, ammettere ciò che non sa e fare calcoli affidabili.
Il nostro nuovo modello che trova e nasconde i dati personali nei testi. Più preciso della versione precedente e migliore di modelli molto più grandi, soprattutto in italiano. Ogni release è firmata digitalmente, così puoi verificarne l'autenticità.
Micro-LLM italiano da 118M parametri, addestrato con meno di €15, ~200 tok/s su CPU. Batte Minerva-350M (3× più grande) su BoolQ-IT.